AIと一緒に、基幹システムの本番リリースをやってみた
先日、担当している業務システムで、わりと大きめの本番リリースを実施しました。データベースの構造変更、マスタデータの一括投入、そして旧システムからのデータ移行。止められない本番環境に、まとめて手を入れる作業です。
規模としては、数十テーブルにまたがるマスタの入れ替えと、数百件規模の人物データの移行。メンテナンス時間を確保して、利用者のアクセスを止めたうえで臨む、いわゆる「失敗できない」タイプの作業です。
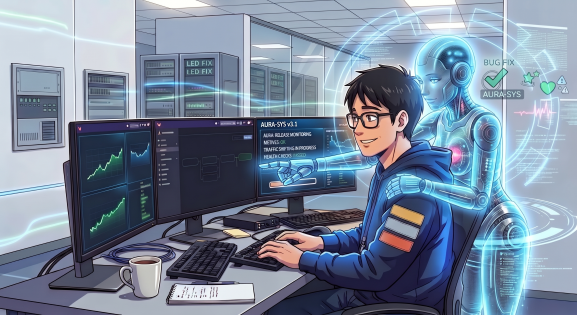
今回はこの一連の作業を、AIコーディングツール「Claude Code」と並走しながら進めてみました。結論から言うと、想像していたより実用的で、しかも想像していなかったところで効きました。その記録を残しておきます。
まず考えたのは「どこまで任せるか」
AIに本番データベースを触らせるのか。ここが最初の分かれ道でした。
結論として採用したのは、「AIは読む、人間が書く」という分担です。
AI側のデータベース接続は、最初から読み取り専用に固定しました。参照系のSQL以外は通らない構成にしておき、更新系は物理的に実行できないようにしておく。そのうえで、実際のデータ投入や確定の判断は、すべて人間の手で行う。
この線引きをしたことで、「AIが暴走したらどうしよう」という不安を最初に消すことができました。AIは本番の状態をいくらでも見に行けるけれど、何も壊せない。この状態を先に作れたことが、今回いちばん効いた設計判断だったと思います。
AIが作ったもの
事前準備の段階から、AIにはかなり働いてもらいました。
- 環境間の差分を洗い出し、それをもとにしたデータベース変更SQL一式(4万行超)
- 実行結果を判定するための検証SQL(160項目)
- データ移行用のSQL群と、その手順をまとめた作業ランブック
- リリース手順書
正直なところ、この量を手で書くのは現実的ではありません。特に検証SQLは、「実行して、結果の判定列を見るだけでOKかNGかが分かる」形まで作り込んでもらいました。これが後々、効いてきます。
当日、いちばん助かった使い方
本番作業中、AIには主に3つのことをやってもらいました。
1. 期待値を先に出しておく
SQLを流す前に、「この処理で何件入るはずか」を全テーブル分、先に算出してもらいます。実行後はその表と結果を突き合わせるだけ。差分がゼロかどうかを見れば済むので、目視で件数を追う作業が消えました。
2. 確定前に、別の目で検証する
更新処理を確定させる前に、AI側の読み取り専用セッションから状態を確認してもらう。作業者と検証者が別々になるので、自分の思い込みでそのまま確定してしまう事故を防げます。
実際、この検証で1件引っかかりました。移行対象のデータに、親レコードが存在しない明細が14行混ざっていたのです。受入環境のテストでは素通りしていたもので、確定前に気づけたので、いったん巻き戻して除去してから入れ直しました。
3. エラーが出たら、原因まで一気に辿る
リリース後の動作確認中、想定外のエラーに遭遇しました。ログに残った1行を渡したところ、数分で原因箇所と再現条件まで特定してくれました。従来なら、ログからコードを追いかけて半日というところです。
AIの成果物にも、漏れは出る
ここは正直に書いておきます。
今回、リリース前後で4件の問題を捕まえたのですが、そのうち2件はAI自身が作った成果物の不備でした。ひとつはコード変換処理の実装漏れ、もうひとつは手順書側の想定漏れです。
ただ、どちらも本番に影響が出る前に見つかりました。理由ははっきりしていて、作ったものと、それを検証するものを別々に用意していたからです。SQLと手順書を突き合わせたら食い違いが見つかった。検証SQLを流したら期待と違う件数が出た。そういう見つかり方でした。
AIが作ったものを、AIが作った別のもので検証する。そして最後は人間が本番の実データと照合する。この多重チェックがなければ、たぶん素通りしていたと思います。
「AIが作ったから安心」ではなく、「AIは速く作れるぶん、検証も厚くできる」。この順序で考えるのが実態に近い気がしています。
気をつけたこと
やってみて「ここは注意が必要だな」と感じた点も、いくつかありました。
成果物の量に、レビューが追いつかない
AIは人間より圧倒的に速く作れるので、放っておくと「読み切れない量の成果物」が出来上がります。今回の量を一行ずつ目で追うのは無理でした。だからこそ、成果物そのものより先に「その成果物を検証する仕組み」を作っておくことが重要になります。人間が確認するのは、全量ではなく判定結果だけ。この形にしておかないと、どこかで破綻します。
前提は、そのつど実データで取り直す
作業が長時間になると、会話の途中で出てきた数字がいつの間にか前提として扱われてしまうことがあります。今回も「その数字はいつ時点のものか」を確認し、あらためて本番の実データを取り直してから作業に進んだ場面が何度かありました。少し前の値でも、作業中の環境では変わっている可能性があります。数分前の値であっても、決め打ちにしないほうが安全です。
「前提の抜け」は、人もAIも同じように起こす
今回見つかった不備のうち、手順書側の想定漏れは、人間が書いていても同じように見落としたであろう種類のものでした。AIだから間違えた、という話ではありません。裏を返せば、AIを使ったからといって、従来やってきたレビューや検証の工程を減らしてよい理由にはならない、ということでもあります。
どれくらい速くなったか
厳密な計測ではなく体感ですが、工程ごとにざっくり比べるとこんな感じでした。
- 差分の洗い出しとSQL一式の作成:3〜4週間 → 約1週間
- 当日のデータベース変更・データ移行・検証:半日〜1日 → 約2時間
- 不具合の原因調査(1件あたり):半日〜1日 → 数十分
- リリース記録・報告資料の作成:1〜2日 → 即日
全体としては3〜4倍速、といったところです。
面白かったのは、短縮幅が大きかったのが「SQLを実行する作業そのもの」ではなく、その前後だったことです。何を作るべきか調べて形にする工程と、結果を検証して記録に残す工程。ここが大きく圧縮されました。
やってみて思ったこと
AIに任せて楽になった、というより、確認の密度を上げられるようになった、という感覚が近いです。
期待値を事前に全部出しておくことも、確定前に別セッションで検証することも、やろうと思えば人間だけでもできます。ただ、コストが高すぎて普通はそこまでやらない。それが現実的な工数でできるようになったので、結果として品質が上がった。速くなったのは、その副産物という感じです。
一方で、判断そのものは最後まで人間の仕事でした。確定するか巻き戻すか、この不整合は許容できるのか、お客様にどう説明するのか。ここはAIに渡せる部分ではないし、渡すべきでもないと思います。
止められない本番環境を触る作業は、これからも緊張します。ただ、隣に「本番の状態をいくらでも調べてくれるが、何も壊せない相棒」がいるのは、思っていたよりずっと心強いものでした。
同じように本番作業でAI活用を検討されている方は、まず「AIに書き込ませない構成」を先に作るところから始めてみるのがおすすめです。